Go 和 Rust 性能谁更快?一次 HTTP 实测告诉你差距在哪里
Go 和 Rust 做同一个 HTTP 服务,谁能处理更多请求?这次实测的答案不是一句“Rust 更快”就能概括:在 5,000 个连接下,Rust 的固定文本吞吐高 78.2%,JSON 序列化高 85.8%;但把主要工作换成固定 CPU 计算后,两端只差约 1%。连接数继续增加,Go 的默认配置还会先遇到 OOM,而设置内存软上限后,问题又变成延迟超标。
这篇文章整理一次 Go 与 Rust HTTP 服务的公平复测,重点看四件事:
- 在相同资源和负载下,吞吐与 P99 尾延迟差多少;
- JSON 工作是否会放大两套实现的差异;
- 更多连接是在提高并发,还是只是在制造排队;
- Go 的内存策略改变后,原本的 OOM 结论还是否成立。
先把结论说窄:在本次 1 个逻辑 CPU、512 MiB 内存的测试环境中,Rust 版本在轻量 HTTP 和 JSON 场景中明显领先;固定 CPU 计算场景则几乎打平。Go 在高连接数下的默认配置会 OOM,但设置 GOMEMLIMIT=384MiB 后,15,000 连接可以稳定完成测试,20,000 连接仍然超过延迟目标。
这些结论只适用于本次实现、依赖、负载和运行环境,不能直接变成“Rust 在所有服务中都比 Go 快”的语言排名。
一、比较的不是语言,而是两份可运行的服务
Go 服务使用标准库 net/http 和 encoding/json;Rust 服务使用 Tokio、Hyper 和 Serde JSON。两端实现相同的 HTTP 路由、请求字段和响应内容,但保留各自常用的 HTTP 库与 JSON 库。
这意味着测试比较的是一组实际工程选择:
Go 1.26.1 +
net/http+encoding/json,对比 Rust 1.97.1 + Hyper 1.12.0 +serde_json1.0.152。
它不是把两门语言编译成完全相同的机器指令,也不是穷举所有库之后寻找各自的最优成绩。读者应该把结果理解为:这两份功能对齐的服务,在有限资源和指定负载下,表现出了什么差别。
本次测试使用 Tokio 的单线程运行时,并把 Go 的 GOMAXPROCS 设置为 1。服务绑定逻辑 CPU 0,资源限制为 1 个 CPU、512 MiB 内存、无 Swap。压测端使用其他 CPU,控制和资源采样也单独安排线程。
运行环境是 WSL2 Ubuntu 24,内核为 6.6.87.2-microsoft-standard-WSL2。WSL2、Windows 和 Hyper-V 仍可能影响调度,因此绝对 RPS 不能直接与另一台机器横向比较。
二、请求做了什么
测试没有只准备一个“Hello World”接口,而是拆成五种负载。每种负载都对应一种常见的服务工作:
| 场景 | 请求 | 服务端工作 | 返回内容 |
|---|---|---|---|
| 固定文本 | GET /hello | 路由和响应 | hello\n |
| JSON 序列化 | GET /json | 序列化完整结构 | 106 字节 JSON |
| JSON 解析 | POST /json | 读取正文并解析完整字段 | 状态和字段摘要 |
| CPU 计算 | GET /compute | 对固定字节执行 50,000 轮 FNV-1a 64 位运算 | 哈希结果 |
| 混合计算 | POST /mixed | JSON 解析后执行相同哈希 | 状态和哈希结果 |
JSON 输入包含整数、字符串、布尔值、数组和嵌套对象:
{"id":42,"name":"benchmark","active":true,"values":[1,2,3,5,8,13,21],"meta":{"region":"test","version":1}}这里有一个容易被忽略的修正:JSON 场景必须真的调用 JSON 库。如果 GET 只是返回预先拼好的字符串,POST 两端解析的字段也不一致,那么测到的就不是“JSON 性能差异”,而是两份不同工作量的代码差异。
本轮还检查了响应正文、状态码、相关响应头、连接复用以及选定非法输入的拒绝行为。哈希结果由独立的 Python 实现复核,两端都返回 3e505859cea6e065。
三、先把压测数据变得可信
旧结果中有两个典型问题。
第一,标称 15,000 或 20,000 连接,并不代表压测端真的建立了这么多连接。旧批次在 15,000 连接下每轮有 4,768 个 connect error,20,000 连接下每轮有 9,768 个;两者相减都得到 10,232。这个数字与压测进程软文件描述符上限 10,240 高度吻合。
服务端提高文件描述符上限还不够,客户端也必须提高。否则测试名称写着“20k 连接”,实际上可能只有约 10k 个连接槽可用。这样的结果不能拿来判断 20k 连接容量。
第二,wrk 的 timeout 不能直接当成全部请求失败率。上游 wrk 4.1.0 会在完成回调中先增加完成请求数,再尝试把延迟写入直方图;如果延迟超出直方图范围,响应仍然可能计入完成请求和 RPS,但会增加 timeout 计数。还没有完成的请求,则不会进入这个回调。
本轮使用带审计计数的 wrk,并检查以下关系:
开始请求数 = 完成响应数 + 中止请求数 + 结束时在途请求数
完成响应数 = 延迟样本数 + 直方图溢出数
同时,2 秒被定义为分析阈值,而不是强制取消请求的计时器。一个超过 2 秒才完成的响应仍会计入实际 RPS 和延迟数据,但该轮会因为超过性能准入规则而判为失败。
这一步很重要:服务进程没有崩溃、压测没有传输错误、延迟目标达标,是三个不同结论。
四、测试如何重复
主批次覆盖固定文本八档连接数,JSON GET / POST 各两档,CPU / mixed 各三档。每个组合在 Go 和 Rust 上分别重复五次,共 180 个正式样本。
每次测试都启动独立服务,先以低负载预热 5 秒,再开始正式的 30 秒窗口。Go 和 Rust 交替运行,避免某一种实现总是在宿主机更忙的时段执行。预热连接关闭后,正式压测重新建立目标连接,所以结果包含初始建连和 accept 的成本。
一个样本只有同时满足以下条件,才进入“有效样本”排名:
- 压测正常退出,并且目标 TCP 连接槽数达到;
- 有完成响应,没有连接、读写或 HTTP 错误;
- 没有 OOM、直方图溢出或超过 2 秒的已完成响应;
- 测试结束时,没有已经等待超过 2 秒的在途请求。
主批次 180 个样本中有 170 个满足性能准入规则。随后又增加 20 个 Go GC 对照样本,其中 15 个有效。全部 200 个样本都保留并完成内部计数核验。
下文的表格默认使用每组五次的中位数。范围是实测最小值到最大值,不是置信区间;各列分别取中位数,因此同一行不一定对应某一次真实运行。
五、5,000 个连接下,Rust 在 HTTP 和 JSON 场景领先
先看一个双方都能正常完成的连接数:5,000。三个 HTTP / JSON 场景在两端都是五次有效运行。图中同时展示吞吐、P99 和 cgroup 内存峰值;精确数值与统计口径见下表。
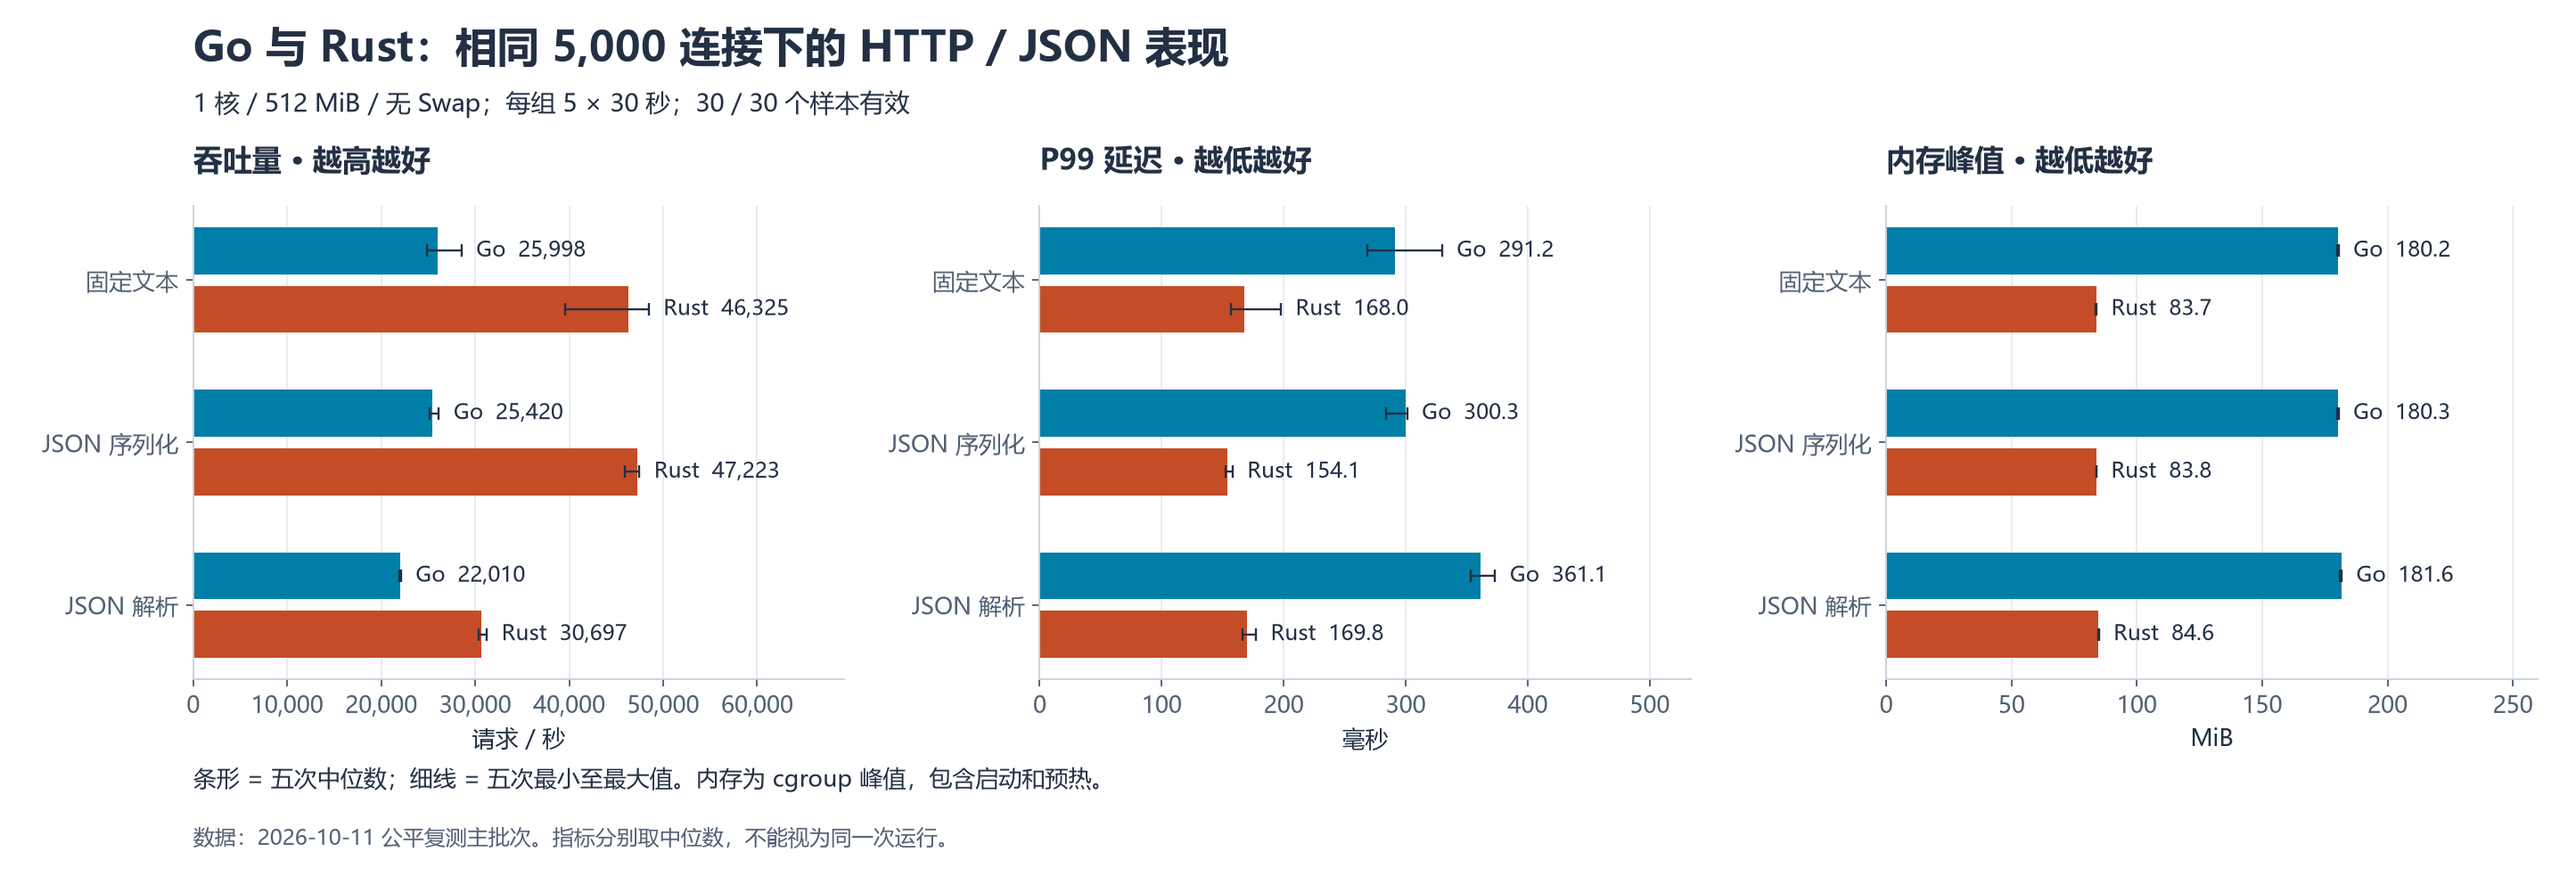
图:5,000 个连接下三种 HTTP / JSON 负载的五次实测范围与中位数。P99 是各轮 P99 的中位数,内存是 cgroup 计费峰值,不是单纯 RSS。
| 场景 | Go RPS | Rust RPS | Rust 吞吐提升 | Go P99 | Rust P99 | Go / Rust 内存峰值 |
|---|---|---|---|---|---|---|
| 固定文本 | 25,997.84 | 46,325.43 | 78.2% | 291.15 ms | 167.95 ms | 180.2 / 83.7 MiB |
| JSON 序列化 | 25,420.24 | 47,222.88 | 85.8% | 300.28 ms | 154.06 ms | 180.3 / 83.8 MiB |
| JSON 解析 | 22,010.50 | 30,696.57 | 39.5% | 361.12 ms | 169.81 ms | 181.6 / 84.6 MiB |
这组结果给出三个观察。
吞吐差距不是某一次异常运行造成的
把同一重复编号的 Go 和 Rust 配成一对,再计算每对的 Rust/Go RPS 比值,五对的范围如下:
| 场景 | 配对比值中位数 | 五对范围 |
|---|---|---|
| 固定文本 | 1.757 | 1.591~1.803 |
| JSON 序列化 | 1.858 | 1.783~1.885 |
| JSON 解析 | 1.402 | 1.382~1.419 |
五对比值全部大于 1,说明本轮重复测试中 Rust 的吞吐优势方向一致。但这仍然是同一台宿主机、同一批负载的五次重复,不能扩展成所有机器上的固定百分比。
尾延迟也出现差距
固定文本、JSON 序列化、JSON 解析三个场景中,Rust P99 分别比 Go 低约 42.3%、48.7% 和 53.0%。也就是说,Rust 不只是单位时间完成的请求更多,已完成请求中较慢的那部分也更短。
不过,P99 只描述已完成的响应。发生 OOM 或测试结束时仍未完成的请求,不会自动变成一条“超长 P99”。因此只有先通过完整准入规则,P99 才适合做正常运行之间的比较。
内存峰值差距很明显,但不能直接归因给 GC
固定文本场景中,Go 的 cgroup 内存峰值为 180.2 MiB,Rust 为 83.7 MiB,Rust 低约 53.5%。两个 JSON 场景也接近这个差距。
这里测到的是 cgroup 计费峰值,不是业务对象大小,也不是纯进程 RSS。它包含初始化、预热,以及被计费的网络和内核开销。没有堆剖析、每连接内存拆解和 GC CPU 时间数据,就不能把约 96 MiB 的差额全部归因于 Go GC。
六、连接数越多,吞吐不会一直增长
固定文本场景覆盖 100 到 20,000 个连接。先看曲线,再看具体数值:两端在连接数增加后都出现吞吐下降、P99 上升;这不是“连接越多,处理能力越强”。
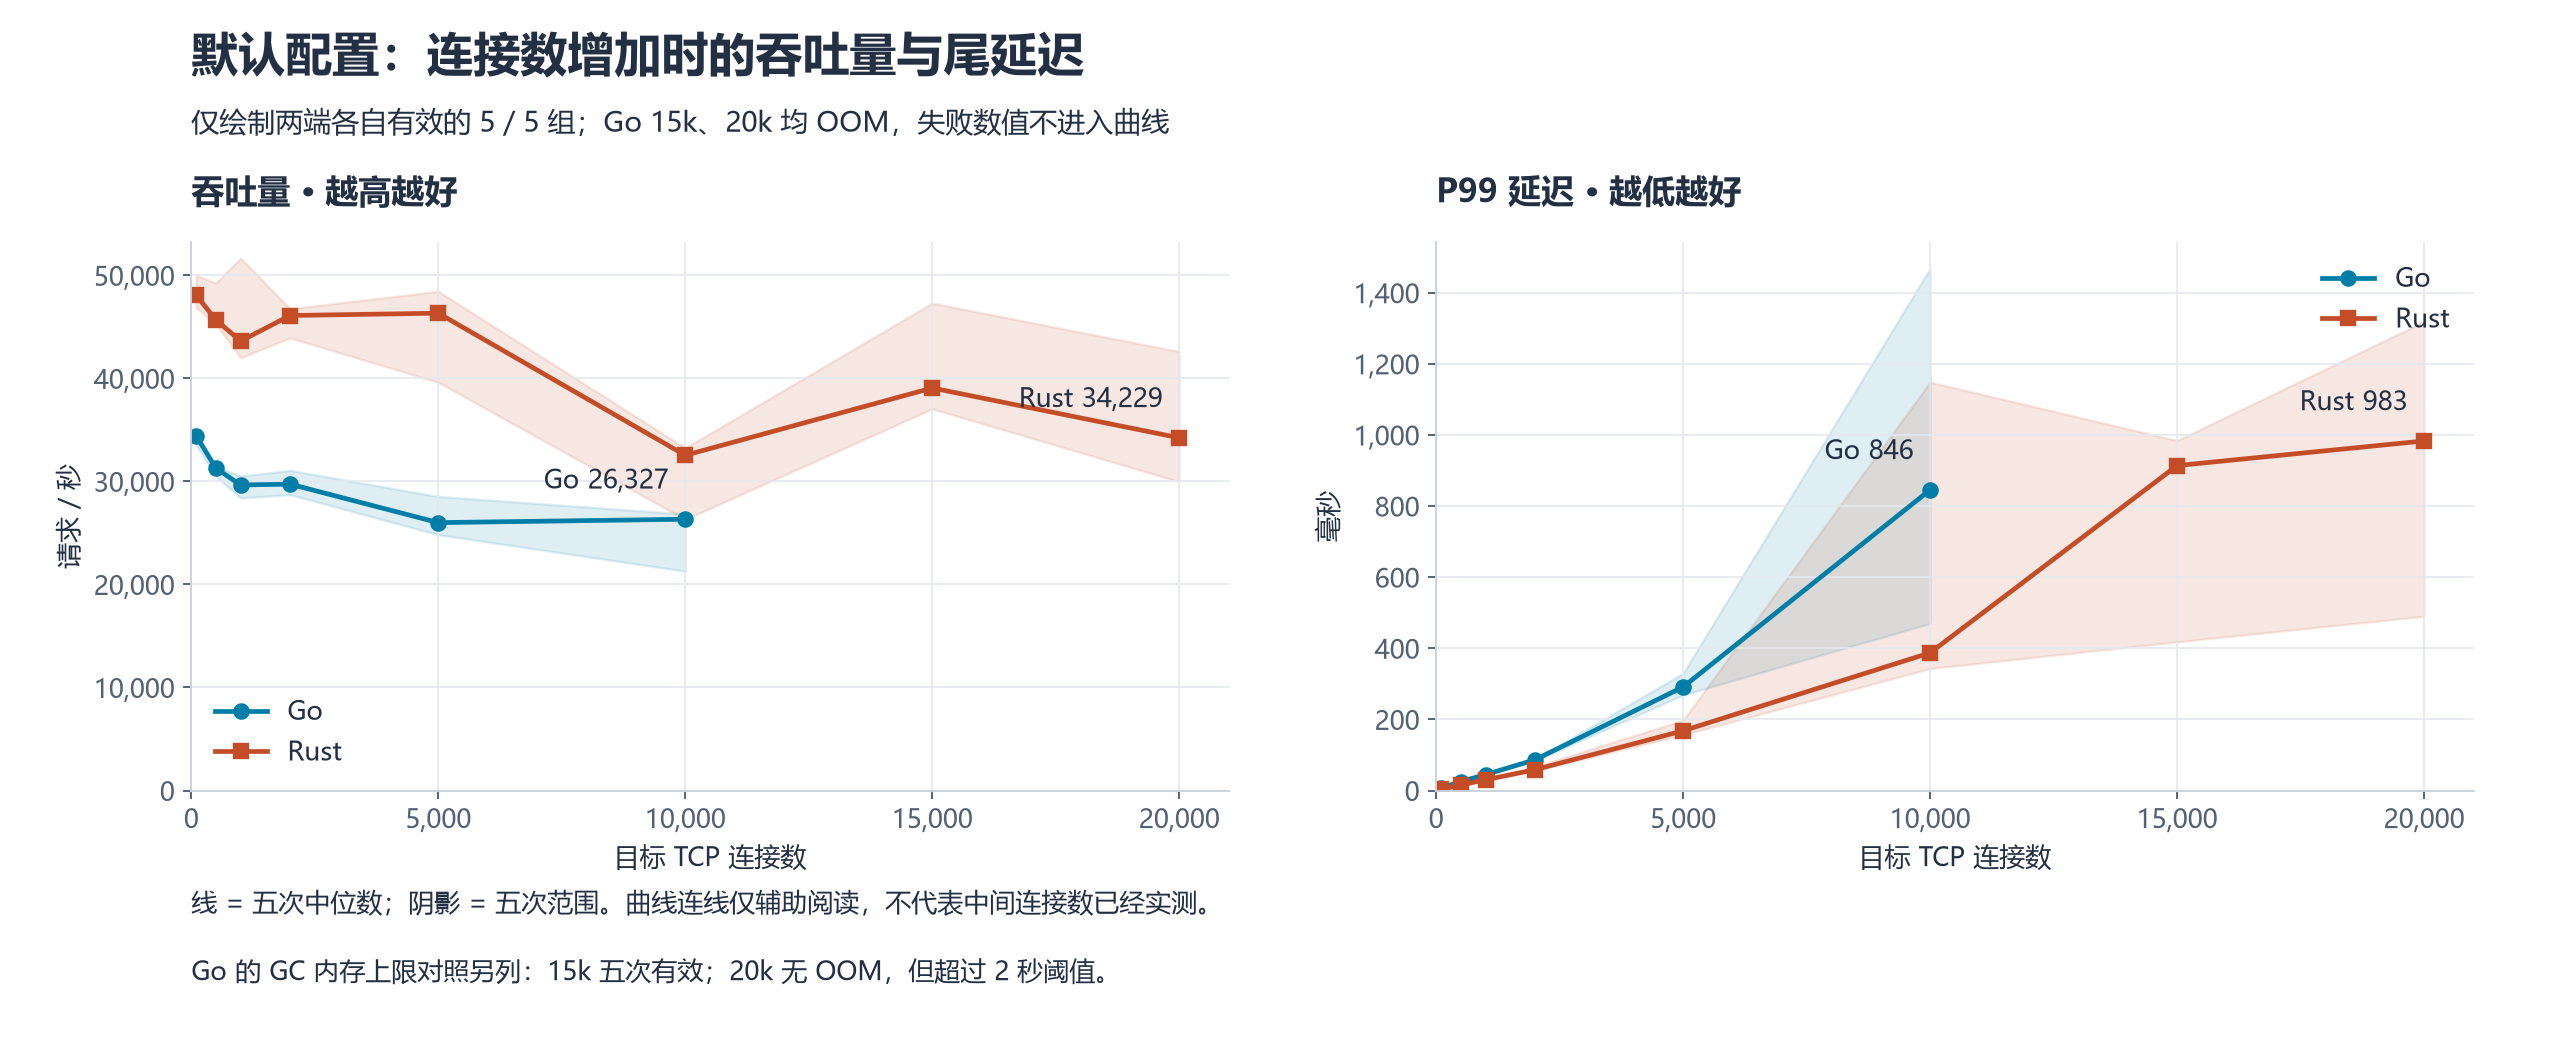
图:固定文本场景的五次实测最小值和最大值;P99 为各轮 P99 的中位数。Go 在 15,000 和 20,000 连接的默认配置下因 OOM 未形成有效排名。
| 连接数 | Go RPS | Rust RPS | Go / Rust P99 | Go / Rust 有效次数 |
|---|---|---|---|---|
| 100 | 34,403 | 48,064 | 6.64 / 2.84 ms | 5/5 · 5/5 |
| 500 | 31,270 | 45,668 | 25.16 / 15.71 ms | 5/5 · 5/5 |
| 1,000 | 29,651 | 43,615 | 44.70 / 30.05 ms | 5/5 · 5/5 |
| 2,000 | 29,734 | 46,099 | 86.33 / 58.45 ms | 5/5 · 5/5 |
| 5,000 | 25,998 | 46,325 | 291.15 / 167.95 ms | 5/5 · 5/5 |
| 10,000 | 26,327 | 32,532 | 845.60 / 387.26 ms | 5/5 · 5/5 |
| 15,000 | — | 39,065 | 不可排名 / 913.89 ms | 0/5 · 5/5 |
| 20,000 | — | 34,229 | 不可排名 / 983.18 ms | 0/5 · 5/5 |
Go 在 100 个连接时约为 34,403 RPS,到了 5,000 个连接反而降到约 25,998;10,000 个连接时吞吐没有恢复,P99 却从 291 ms 增至 846 ms。Rust 也不是连接越多越快:5,000 个连接约 46,325 RPS,10,000 个连接降为约 32,532。
原因并不神秘:在只有一个 CPU 配额的服务中,更多连接可以让更多请求排队,却不会凭空增加每秒可完成的工作量。5,000 个固定文本连接时,两端服务 CPU 使用率都接近 99%,说明服务已经高度利用这份计算预算。
因此,连接数不是吞吐能力的同义词。容量规划至少要同时给出到达率、延迟目标、错误率和持续时间。只报“能挂多少连接”,很容易把排队能力误当成处理能力。
七、CPU 计算场景:两端几乎打平
固定文本和 JSON 场景的差距,不能推导出所有工作负载都会有同样比例的差距。把服务端主要工作换成相同的 50,000 轮 FNV-1a 64 位计算后,结果变了:
| CPU 连接数 | Go RPS | Rust RPS | Go / Rust 平均延迟 | Go / Rust P99 |
|---|---|---|---|---|
| 1 | 247.00 | 250.05 | 4.05 / 4.00 ms | 5.92 / 5.77 ms |
| 16 | 249.32 | 253.22 | 64.09 / 63.10 ms | 76.56 / 65.99 ms |
| 64 | 247.74 | 249.82 | 257.13 / 254.38 ms | 278.39 / 263.60 ms |
单连接时,每个请求约 4 ms,所以吞吐约为每秒 250 个请求。连接增加到 64 个后,吞吐仍然在 250 左右,平均延迟却达到约 254~257 ms。
可以做一个简单的量级检查:
64 个在途请求 / 250 请求每秒 ≈ 0.256 秒这个结果与实测平均延迟接近,说明新增连接主要换成了等待时间,而不是更多计算能力。
mixed 场景先解析相同 JSON,再执行相同哈希计算。在 64 个连接下,Go 约 249.09 RPS,Rust 约 251.79 RPS,仍然接近。这里不能说 JSON 解析“没有成本”,只能说在这组端到端负载中,固定 CPU 计算占据了主要工作量,JSON 差异被压小了。
这也是性能选型最容易被忽略的一点:如果业务的大部分时间花在数据库、加密、压缩或某段固定计算上,那么一个轻量 HTTP 场景中的语言差距,未必会按比例传递到整体服务。
八、Go 的 OOM 结论,需要放回 GC 配置里看
默认 Go 配置为 GOGC=100,没有设置 GOMEMLIMIT。在 512 MiB 总内存限制下,15,000 和 20,000 个连接各测试五次,全部 OOM;Rust 两档则全部完成。
这个结果可以如实记录,但不能直接写成“Go 的连接上限是 10,000”。因为默认 GC 策略并不等于为 cgroup 总内存量身定制的策略,所以增加一个对照批次:
GOMEMLIMIT=384MiB
GOGC=100
服务总内存限制仍为 512 MiB
384 MiB 是本次实验选择的对照值,给网络、内核和其他开销预留名义上的 128 MiB,并没有通过参数扫描证明它是最优配置。
Go 官方文档对 GOMEMLIMIT 的说明见:
https://go.dev/doc/gc-guide#Memory_limit
对照结果如下:
| 配置 | 连接数 | 实现 | 有效 | OOM | RPS 中位数 | P99 | 内存峰值 |
|---|---|---|---|---|---|---|---|
| 默认 | 15,000 | Go | 0/5 | 5/5 | — | — | 512.00 MiB |
| 默认 | 15,000 | Rust | 5/5 | 0/5 | 39,065 | 914 ms | 248.70 MiB |
| GC 对照 | 15,000 | Go | 5/5 | 0/5 | 31,392 | 640 ms | 447.98 MiB |
| GC 对照 | 15,000 | Rust | 5/5 | 0/5 | 47,164 | 350 ms | 248.61 MiB |
| 默认 | 20,000 | Go | 0/5 | 5/5 | — | — | 512.00 MiB |
| GC 对照 | 20,000 | Go | 0/5 | 0/5 | 12,965* | 2,492 ms* | 498.83 MiB |
| GC 对照 | 20,000 | Rust | 5/5 | 0/5 | 36,788 | 986 ms | 330.88 MiB |
* 20,000 连接的 Go GC 对照没有 OOM,但超过了本文的 2 秒延迟准入阈值,因此这些数字只描述失败运行,不能与有效样本正常排名。
15,000 个连接的变化很清楚:Go 从五次 OOM 变为五次有效,说明运行时内存策略确实影响了结果。但内存策略不能把所有问题都消除。20,000 个连接时,Go 虽然不再 OOM,内存峰值仍接近 499 MiB,P99 达到约 2.49 秒。
因此要区分三个状态:
- 进程还活着;
- 没有发生传输错误;
- 满足延迟目标。
20,000 连接的 Go 对照只满足前两个,不能称为一次成功的性能运行。
这组对照也不能证明所有慢请求都由 GC 引起。本轮没有记录 GC trace、堆剖析或调度剖析,无法精确拆分 GC、HTTP 库、连接缓冲区和调度的贡献。它只能证明:在这个资源限制和连接模型下,Go 的表现对运行时内存策略敏感。
九、怎样把结果用于工程选择
如果实际服务接近本次的轻量 HTTP 和小 JSON 负载,Rust 版本在这份实现中给出了更高吞吐、更低 P99 和更低 cgroup 内存峰值。它值得作为进一步验证的起点,但不能替代真实路由、中间件和业务数据的测试。
如果服务主要做计算,语言差距可能明显收窄。本次固定哈希和 mixed 场景的两端吞吐都约 250 RPS;用固定文本场景的 78.2% 提升去估算完整业务收益,会把瓶颈位置忽略掉。
如果选择 Go,受限内存部署不能只看默认运行时配置。GOMEMLIMIT 可以改变 OOM 的表现,但它是软限制,设置得更紧也可能增加 GC 工作;合适的值必须结合正文大小、连接模型、存活对象和延迟目标实测。
如果选择 Rust,也不能把本次 20,000 连接有效运行理解成通用容量。测试只有 30 秒,没有数据库、TLS、反向代理和真实网络链路,也没有覆盖长时间空闲连接、突发流量和多核扩展。
十、这次测试没有回答什么
本次数据的边界同样是结论的一部分。
宿主机没有完全隔离。 WSL2 来宾内做了 CPU 绑定,但 Windows、Hyper-V 调度和后台任务仍可能影响结果。
压测是闭环模型。 wrk 在响应完成后继续发起请求。服务变慢时,发送节奏也会受到影响;它不能替代固定到达率的过载测试。
延迟只覆盖完成响应。 连接建立本身不计入单次延迟,但正式窗口包含初始建连;结束时仍在途的请求单独记录,没有被伪造为完整延迟样本。
资源指标不是细粒度剖析。 cgroup 内存峰值包含启动和预热,CPU 采样也覆盖启动与收尾,不能直接解释某个函数分配了多少内存或消耗了多少 CPU。
场景和重复数有限。 每组五次、每次 30 秒,能够暴露本轮波动,但不能提供跨硬件、跨时间的普遍置信区间。CPU 场景是固定算法,JSON 是小对象,测试也没有覆盖多核扩展。
下一轮如果要继续,应优先补充固定到达率、数小时稳定性、真实业务请求、多核扩展,以及连接内存、GC 和调度的剖析。
十一、最终结论
这次测试没有测出一个脱离场景的“最快语言”,而是测出了几种不同的工程结果:
| 对比项 | 结果 |
|---|---|
| 固定文本,5,000 连接 | Rust 吞吐高 78.2%,P99 约低 42.3% |
| JSON 序列化,5,000 连接 | Rust 吞吐高 85.8%,P99 约低 48.7% |
| JSON 解析,5,000 连接 | Rust 吞吐高 39.5%,P99 约低 53.0% |
| 固定文本内存峰值 | Rust 为 83.7 MiB,Go 为 180.2 MiB |
| 固定 CPU 计算,64 连接 | 两端约 250 RPS,差距约 1% |
| Go 默认配置,15k / 20k 连接 | 两档都 OOM |
Go GOMEMLIMIT=384MiB,15k 连接 | 五次有效,无 OOM |
Go GOMEMLIMIT=384MiB,20k 连接 | 无 OOM,但 P99 超过 2 秒 |
更稳妥的判断是:本次实现中,Rust 在 HTTP、JSON 和高连接数内存占用上表现更好;当 CPU 计算成为主要瓶颈时,两端差距大幅缩小;Go 的高连接数结果则明显受到 GC 内存策略影响。
这比“Rust 一定比 Go 快”更窄,但也更接近性能测试真正能告诉我们的事情:先把工作量、资源预算、统计口径和失败样本对齐,再讨论语言选择。
云服务器推荐
如果你需要部署博客、Docker 服务或个人项目,可以参考:
本文包含推广链接。通过链接购买不会增加你的费用,但我可能获得少量佣金。
评论