如果要给 Agent 搭一套可观测平台,应该从哪里开始?
假设你让一个编码 Agent“读一下配置文件,再把超时时间改成 30 秒”。它最后回复“已经改好了”,但你打开文件,发现内容没变。
问题出在哪一步?模型理解错了要求,工具读错了文件,还是写入失败了?如果只保存用户输入和最终回答,这几个原因很难分辨。
给 Agent 做可观测,就是把中间过程也记录下来:每次模型收到了什么、返回了什么,每次工具用了什么参数、执行结果如何,以及每一步花了多长时间。这样出了问题,就能沿着同一次任务往回查,而不是从一堆日志里猜。
Langfuse 是什么,能帮我们看到什么?
Langfuse 是一个面向大模型应用的开源平台,可以自建,也可以使用它的云服务。这里主要使用它的运行追踪功能:把 Agent 一次任务里的模型调用、工具调用、输入输出、耗时和 token 用量集中展示出来。
它不是 Agent 的执行引擎,也不会接上之后就自动知道你的工具做了什么。Agent 端需要在这些动作发生时采集数据,再发送给 Langfuse。平台负责接收、组织和展示这些记录。
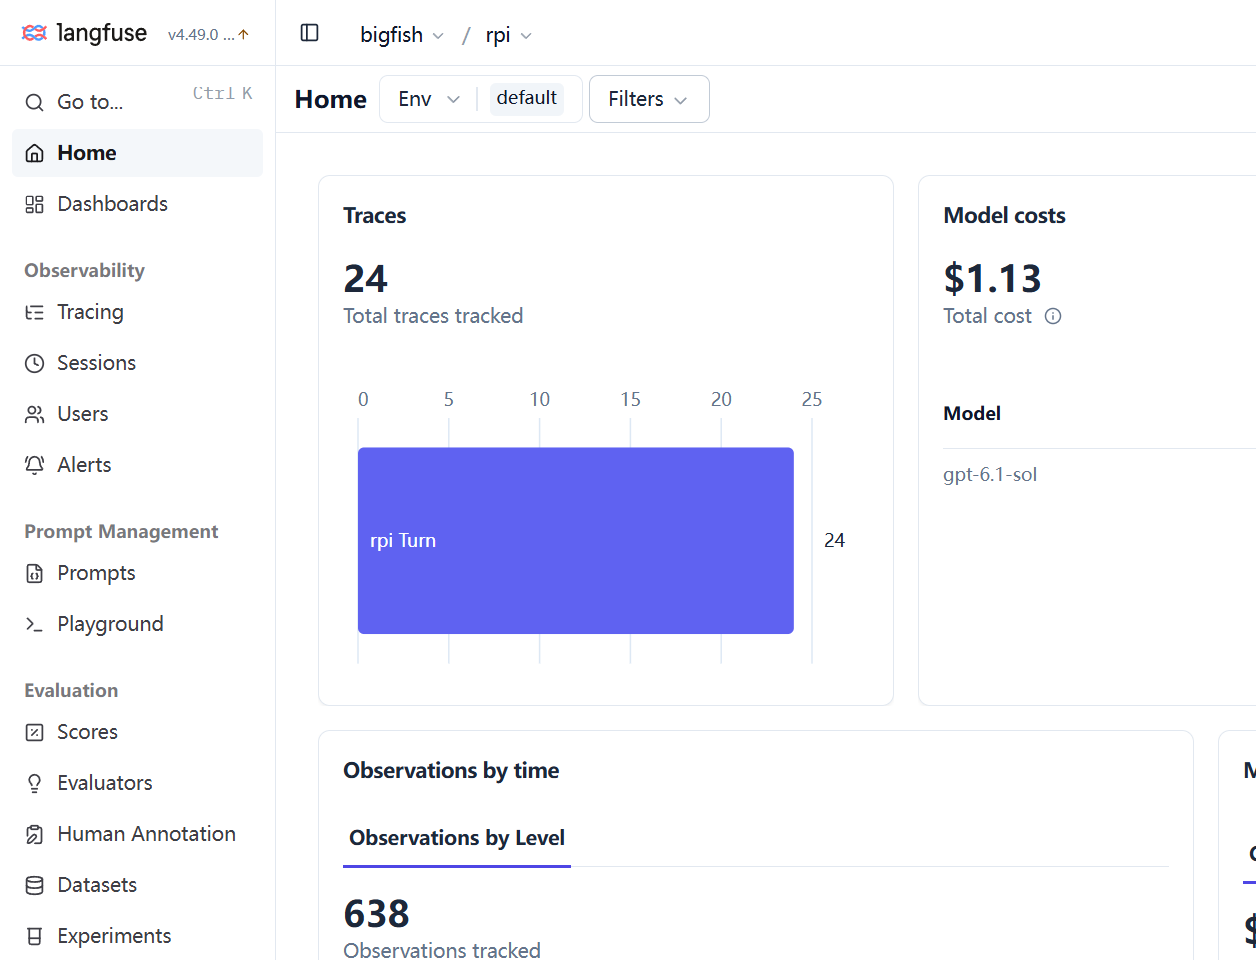
这张图来自自建实例的 rpi 项目。先看运行次数、模型用量和费用,再看 observations 随时间的分布,就能知道这个时间段里有没有任务运行、哪些时段出现了错误。图里的统计只代表截图时选定的时间范围,不是性能测试结论。
后面的截图同样来自该实例,截图时界面版本为 v4.49.0 OSS。画面裁掉了账号侧栏;工具错误图中的本地绝对路径做了脱敏。
沿着前面的例子,我们希望看到这样的过程。下面是示意,不是一次真实运行的截图或测试结果:
用户:把配置里的超时时间改成 30 秒
  ├── 第一次模型调用:决定读取配置
  ├── 读取文件:记录路径、参数、返回内容
  ├── 第二次模型调用:决定修改配置
  ├── 写入文件:记录修改内容、成功或错误
  └── 最后一次模型调用:生成回复
如果写入工具报错,但 Agent 仍然回复“已经改好了”,把工具结果和最后一次模型调用的输入放在一起,就可以继续检查:错误有没有传回模型,模型有没有正确处理它。
这些记录能帮助定位问题,但不会自动判断答案是否正确。评估还需要另外定义评分标准、准备评测样例;本文先把运行过程记录完整,不展开评估体系。
本文使用 Langfuse v4,也就是 Langfuse 的第 4 个主要版本。下面的数据模型和写入配置都以它为背景。版本号只是说明适用环境,不需要先了解旧版才能往下读。
本文的接入案例使用 rpi,一个用 Rust 实现的编码 Agent,能够调用模型、读取文件和执行工具。负责把它的运行数据送到 Langfuse 的是 rpi-langfuse,一个用原生 Rust 实现的 rpi 插件。它不是 Langfuse 服务本身,而是运行在 Agent 一侧的数据采集与上报组件。
你不一定使用 rpi,也可以把后面的“模型请求开始、工具调用结束”等位置,对照到自己的 Agent 实现里。
先记录什么:一次任务和其中的每个动作
先用三个概念给上面的过程命名:
- Trace(追踪记录):一段完整的执行过程。本文把 Agent 的一轮运行作为一条 trace。
- Observation(观测记录):过程里的一次具体动作,例如一次模型请求、一次工具执行。
- Session(会话):多轮运行的分组。同一个用户连续发几条消息,可以产生多条 trace,再归入同一个 session。
在 Langfuse v4 的数据模型里,一条 trace 可以理解为一组共享同一个 trace_id 的 observations。每条 observation 再通过 parentObservationId 记录它属于哪个上层动作:
trace_id = t-001
└── agent turn                 span / chain
    ├── call deepseek          generation
    ├── read_file              tool
    └── call deepseek          generation
Session 是更外层的分组。比如一个用户连续发送了多轮消息,每轮可以是一条 trace,几条 trace 再通过同一个 session_id 归到同一个会话里。
Langfuse 官方文档把 v4 的存储描述成一张 observations 表。每一行是一条 observation,同时带有 trace 级属性的副本:
| observation | type | trace_id | parent | trace 级属性 |
|---|---|---|---|---|
| Agent turn | SPAN | t-001 | 无 | session、user、tags |
| 模型调用 | GENERATION | t-001 | Agent turn | session、user、tags |
| 工具调用 | TOOL | t-001 | Agent turn | session、user、tags |
这解释了一个很容易漏掉的细节:如果 session_id 只写在根 span 上,子 observation 那一行可能没有这个值。之后按 session 筛选或聚合时,结果就不完整。
所以 rpi-langfuse 在序列化每个 span 时,都会把需要参与筛选的 trace 级属性一起带上,而不是只给根 span 写一份。
点开一条记录,实际能看到什么?
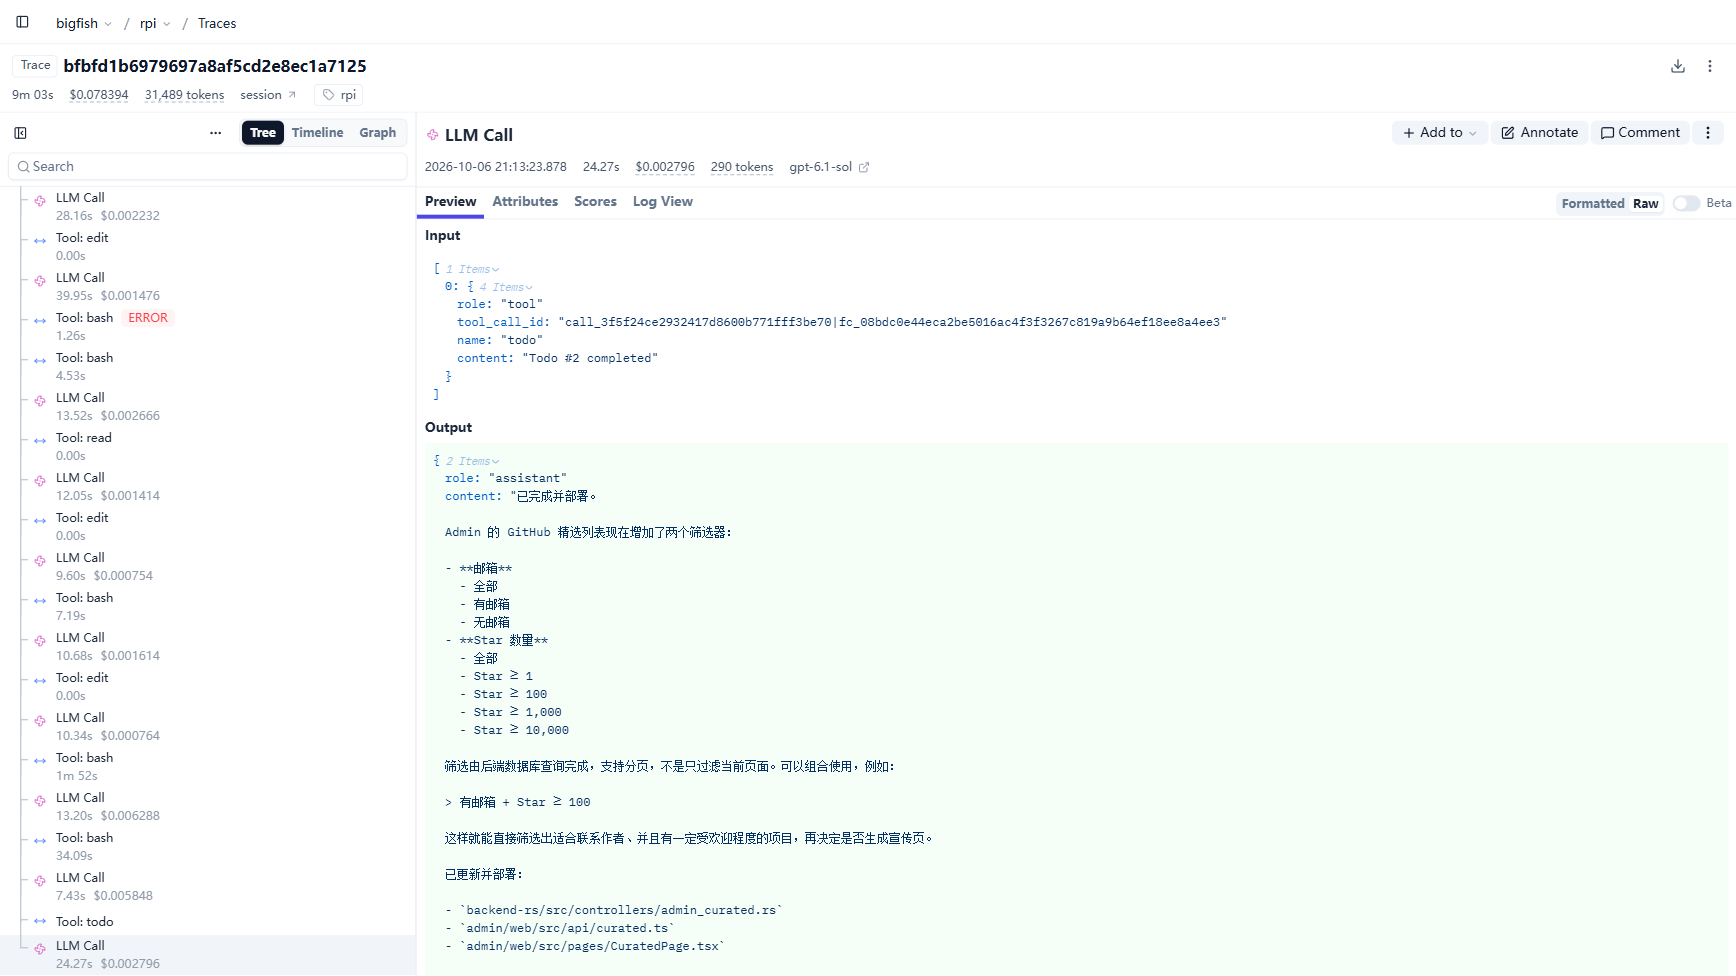
左侧是这轮运行里的模型请求和工具执行,右侧是选中的一次 LLM Call。这个页面把整轮任务的总耗时、总用量,和单次模型请求的耗时、用量分开显示,排查时不要混为一谈。
图中这次模型请求的 Input 展示了 todo 工具的返回信息,Output 是模型给出的最终回复。至少可以核对“模型收到的记录里有没有工具结果”以及“它最终怎样回答”。不过,界面里展示的 input 是否包含完整请求上下文,还取决于 Agent 端上报了哪些内容,不能仅凭这一张图断言完整 messages 都已记录。
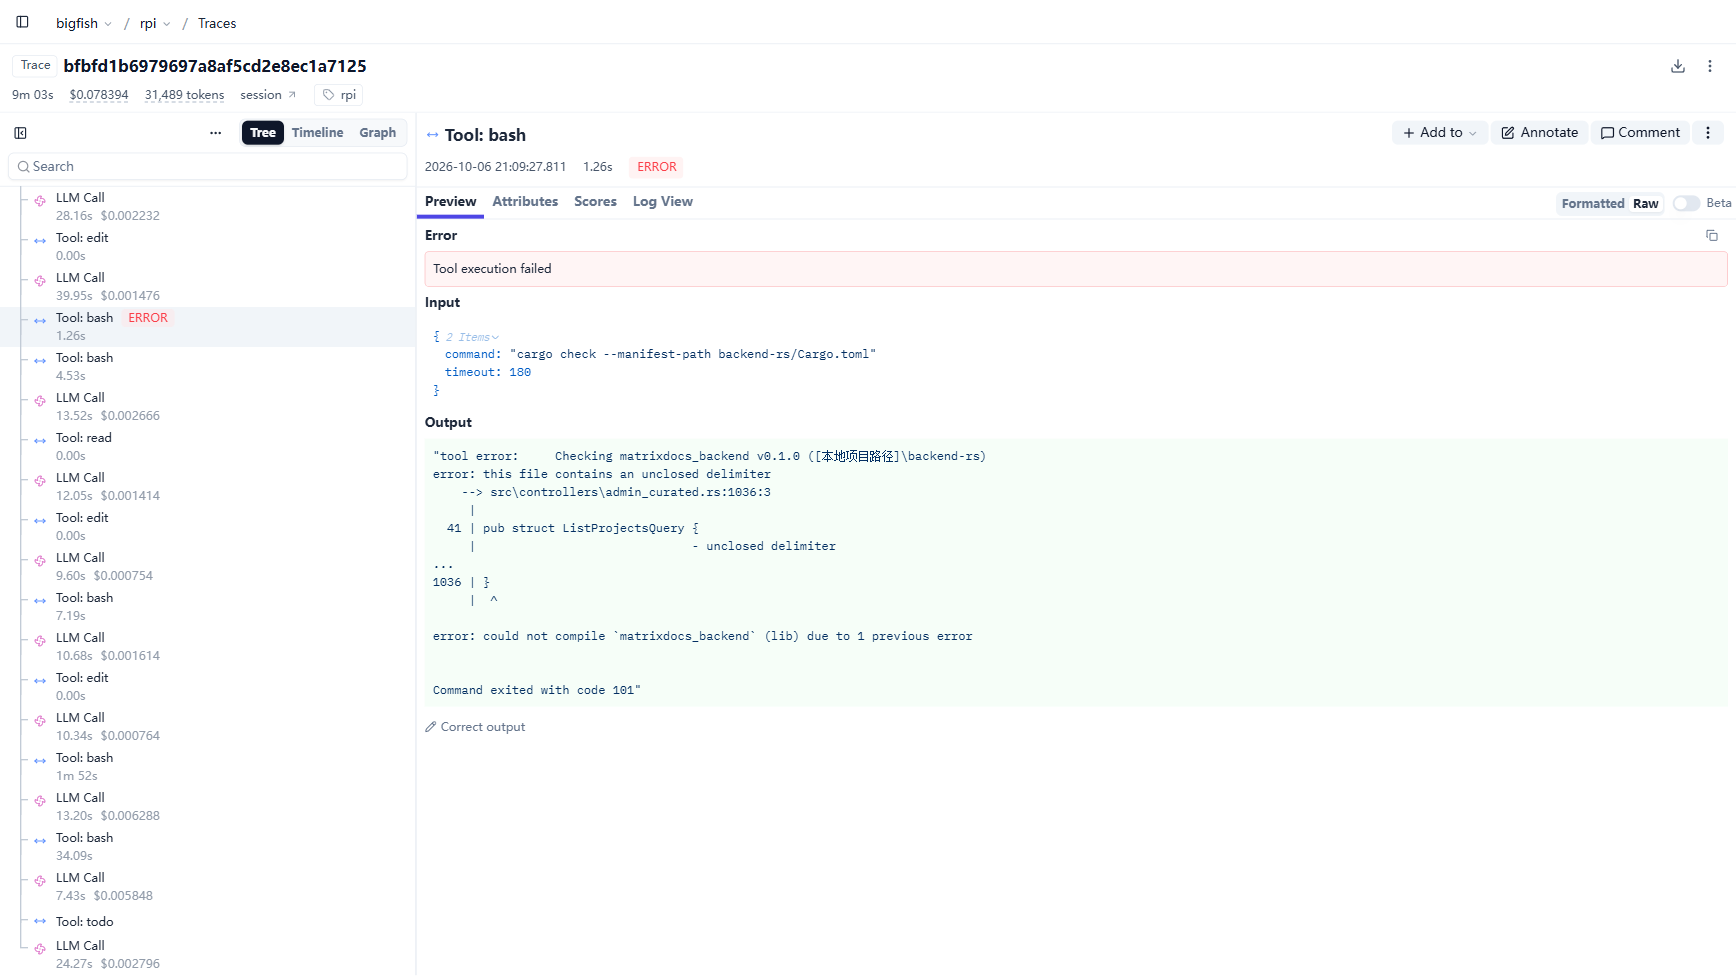
再选中同一轮运行里的红色 ERROR 记录,就能看到失败的是一次 cargo check:Input 是命令和超时参数,Output 里有 unclosed delimiter 的编译错误,以及退出码 101。
这里的 ERROR 表示这一步工具执行失败,不代表整轮任务一定失败。左侧还保留了后续模型和工具动作,可以继续查它是否尝试修复。截图展示的是实际编译错误,与开头“修改超时时间”的假设场景不是同一个任务。
模型调用和工具调用,为什么要区分类型?
耗时相同的两条记录,排查方向可能完全不同:模型调用慢,要看模型响应和 token 数;工具执行慢,要看工具参数和返回结果。类型就是用来说明“这一步在做什么”的。
Langfuse 可以用下面三类描述这些动作:
span:Agent 一轮运行、工作流或普通操作generation:一次 LLM 请求tool:一次工具调用
但类型由上报端指定,并不是名字里有 Tool: 就自动变成 tool。本次截图的数据来自 rpi-langfuse 0.4.1,工具记录实际按 span 上报;前面的 TOOL 表格是类型划分示意,不是对截图实际枚举值的抄录。验证接入时,工具名称和 observation 类型都需要核对。
Langfuse 还支持 event、embedding、agent、chain、retriever、guardrail、evaluator 等类型。通过 OTLP 上报时,类型写在 langfuse.observation.type 属性里;读回 v2 API 时通常显示为大写枚举,例如 GENERATION。
Agent 端怎么采集:在动作开始和结束时留下记录
记录不会凭空出现在平台里。要在 Agent 一轮运行开始、模型请求开始和结束、工具执行开始和结束这些位置采集。
在这个案例里,采集工作由 rpi-langfuse 插件负责。rpi 在运行过程中提供模型请求、工具调用等生命周期事件,插件在这些事件发生时记录输入、输出和时间,再把记录组织好,发送给 Langfuse。
可以把三者的分工理解为:
rpi:执行 Agent 任务
  ↓ 生命周期事件
rpi-langfuse:用原生 Rust 实现的插件,负责采集和上报
  ↓ 运行记录
Langfuse:接收、组织和展示观测数据
插件内部用 span 保存一次操作的记录:开始时记下输入和开始时间,结束时补上输出、结束时间,以及模型调用的 token 用量。记录完成后,再转换成 OTLP 报文导出。Span 是 OpenTelemetry 对一次操作记录的称呼;发送到 Langfuse 后,它对应一条 observation。
大致对应关系如下:
| rpi 生命周期 | Langfuse observation | 记录内容 |
|---|---|---|
BeforeAgentStart | 根 span | prompt、session、Agent 名称 |
BeforeProviderRequest | generation | 模型、messages、参数 |
AfterProviderResponse | generation 收尾 | output、token usage、TTFT |
ToolCall | tool | 工具名、参数、调用开始时间 |
ToolResult | tool 收尾 | 返回值、错误、结束时间 |
MessageEnd | 根 span 收尾 | 整轮执行的结束时间 |
实现上,扩展里有一个 span 缓冲区:
Agent 开始
  └── 创建根 span
      ├── 模型请求开始:创建 generation
      ├── 模型响应回来:补 output 和 usage
      ├── 工具调用:创建 tool
      ├── 工具返回:补 output 并结束 tool
      └── 本轮结束:结束根 span

只导出已经结束的 span
这里有两个实际考虑。
第一,模型的 input 在请求开始时就有了,但 output 和 usage 要等响应回来才知道。过早发送,会得到一条没有结束时间、没有输出的 generation。
第二,Agent 可能在一轮里调用多个工具。工具 span 不能脱离当前的 trace_id,否则 Langfuse 里会出现几条互相无关的 trace。
因此扩展内部先维护完整的 span 记录,等它具备起止时间后,再转换成 OTLP 的 span。这个转换发生在导出时,trace 名称、session、tags 和 metadata 也在这里统一补到每个 observation 上。
把记录送进平台:OpenTelemetry 和 OTLP 是什么?
现在有了运行记录,接下来需要约定发送格式。OpenTelemetry 是一套采集和传输观测数据的标准及工具;OTLP 是它用于传输这些数据的协议。可以简单理解为:Agent 不用自己发明一套报文,而是按约定的格式发送 span,让平台能够识别。
Langfuse 支持这种写入方式。Python 和 JavaScript/TypeScript 应用可以优先使用官方 SDK;本文的 Rust 扩展直接发送 OTLP JSON,所以后面会拆开看请求体。OTLP 并非 v4 才出现的能力,这里说明的是使用它写入 v4 数据路径的配置。
以下操作假定你已经有一个可访问的 Langfuse v4 实例,并拿到了项目的 public key 和 secret key。自建服务器的安装步骤不在本文范围内;先把一条运行记录接通,再扩展到所有模型和工具调用。
写入和读取路径如下:
rpi-langfuse
    │
    │ OTLP/HTTP JSON
    ▼
POST /api/public/otel/v1/traces
    │
    ▼
Langfuse v4 observations
    │
    ├── GET /api/public/v2/observations
    └── GET /api/public/v2/metrics
请求头至少需要这些:
Authorization: Basic <base64(public-key:secret-key)>
Content-Type: application/json
x-langfuse-ingestion-version: 4
Basic Auth 的内容就是 public key 和 secret key,中间用冒号连接:
echo -n "pk-lf-xxx:sk-lf-xxx" | base64 -w 0x-langfuse-ingestion-version: 4 很重要。直接使用 OTLP exporter 时,如果没有这个 header,数据可能进入兼容旧版本的路径,v2 读取接口不会马上看到数据。官方文档对延迟上限在不同页面有 10 分钟和 15 分钟两种表述,所以排查时不要把具体分钟数当成 SLA,先检查 header 是否真的被代理转发。
OTLP 端点支持 HTTP JSON 和 protobuf,也支持 gzip;目前不支持 gRPC。rpi-langfuse 使用的是 JSON,原因很简单:调试时可以直接抓请求体看报文。
一条 OTLP trace 报文
OTLP 的外层结构不是 Langfuse 专属格式,而是 OpenTelemetry 的 ExportTraceServiceRequest:
{
  "resourceSpans": [
    {
      "resource": {
        "attributes": [
          {"key": "service.name", "value": {"stringValue": "rpi"}},
          {"key": "telemetry.sdk.language", "value": {"stringValue": "rust"}}
        ]
      },
      "scopeSpans": [
        {
          "scope": {"name": "rpi-langfuse", "version": "0.4.1"},
          "spans": [
            {"...": "这里放具体 span"}
          ]
        }
      ]
    }
  ]
}
三层的职责可以简单记成:
resource:哪个服务产生了数据,例如service.name = rpiscope:哪个埋点库产生了数据,例如rpi-langfusespans:具体发生了什么
真正和 Langfuse observation 对应的是 spans 里的对象。
一个 generation span
下面是删减后的模型调用报文:
{
  "traceId": "4bf92f3577b34da6a3ce929d0e0e4736",
  "spanId": "00f067aa0ba902b7",
  "parentSpanId": "a3ce929d0e0e4736",
  "name": "LLM Call",
  "kind": 1,
  "startTimeUnixNano": "1791177524742000000",
  "endTimeUnixNano": "1791177530901000000",
  "attributes": [
    {"key": "langfuse.observation.type", "value": {"stringValue": "generation"}},
    {"key": "langfuse.observation.model.name", "value": {"stringValue": "deepseek-v4.1-flash"}},
    {"key": "langfuse.observation.model.parameters", "value": {"stringValue": "{\"temperature\":0.7}"}},
    {"key": "langfuse.observation.input", "value": {"stringValue": "[{\"role\":\"user\",\"content\":\"...\"}]"}},
    {"key": "langfuse.observation.output", "value": {"stringValue": "{\"content\":\"...\"}"}},
    {"key": "langfuse.observation.usage_details.input", "value": {"intValue": "2929"}},
    {"key": "langfuse.observation.usage_details.output", "value": {"intValue": "374"}},
    {"key": "langfuse.trace.name", "value": {"stringValue": "rpi Turn"}},
    {"key": "langfuse.session.id", "value": {"stringValue": "session-001"}}
  ]
}
这里最值得注意的是四件事。
ID 是 W3C 格式
traceId 必须是 32 位小写十六进制字符串,spanId 是 16 位小写十六进制字符串。像 obs-0000000000000001 这样的自造 ID 不能直接拿来当 OTLP ID。
parentSpanId 为空表示物理根 span。它只决定物理父子关系。Langfuse v2 还有一个 isRootObservation,表示语义上的 application root,不能把这两个概念混为一谈。
时间是纳秒,而且 JSON 里通常是字符串
startTimeUnixNano 和 endTimeUnixNano 是 Unix 纳秒时间。在 OTLP JSON 映射中,64 位整数通常序列化成字符串。
Langfuse 对缺失或无法解析的时间会做补齐,但这只是在避免整条请求失败:如果只传了一端,另一端可能被复制,最后得到零时长 observation。rpi-langfuse 会在导出前检查每个 span 的起止时间。
结构化输入要先转成字符串
OTLP span attribute 是带类型标签的标量值:
{"stringValue": "text"}
{"intValue": "123"}
{"doubleValue": 0.5}
{"boolValue": true}
它不是一个可以直接塞任意 JSON 对象的字段。因此 input、output、model.parameters 和 usage_details 在报文里通常是 JSON 字符串,Langfuse 再按自己的字段映射处理。
Langfuse 的属性名决定数据去哪
最常用的属性可以这样对照:
| Langfuse 字段 | OTLP 属性 |
|---|---|
| observation type | langfuse.observation.type |
| observation input | langfuse.observation.input |
| observation output | langfuse.observation.output |
| model | langfuse.observation.model.name |
| model parameters | langfuse.observation.model.parameters |
| token usage | langfuse.observation.usage_details |
| trace name | langfuse.trace.name |
| user | langfuse.user.id |
| session | langfuse.session.id |
| release | langfuse.release |
| version | langfuse.version |
| trace metadata | langfuse.trace.metadata.<key> |
trace 级属性要在每个需要筛选或聚合的 span 上重复写入。rpi-langfuse 的做法类似这样:
for span in spans {
    span.attributes.push(attr_str(
        "langfuse.trace.name",
        &trace.name,
    ));

    if let Some(session_id) = &trace.session_id {
        span.attributes.push(attr_str(
            "langfuse.session.id",
            session_id,
        ));
    }

    for (key, value) in &trace.metadata {
        span.attributes.push(attr_str(
            &format!("langfuse.trace.metadata.{key}"),
            value,
        ));
    }
}
如果只是把普通的 http.method 直接放进 span,它会落到 metadata.attributes 这类 catch-all 位置,能查看,但不一定能作为 Langfuse metadata 的一级字段筛选。需要筛选的字段,显式使用 langfuse.trace.metadata.<key>。
Token 用量怎么记:缓存命中的部分不要算两遍
模型响应里的 usage,就是这次请求的用量统计。Token 可以先理解为模型处理文本的计量单位;输入和输出用量能帮助我们判断一次请求处理了多少内容,也是计算费用的依据之一。
这里容易弄混的是:有些供应商返回的“输入总数”已经包含了“命中缓存的输入数”。缓存命中表示一部分输入复用了缓存,不是又多处理了一份独立输入。供应商可能对普通输入和缓存输入采用不同价格,所以记录时需要把它们分开。
用一个小例子看:输入总共 100 个 token,其中 80 个命中缓存,那么没有命中缓存的输入就是 20 个。如果把 100 和 80 当作两项互不重叠的输入用量相加,就变成了 180,重复算了缓存的部分。
对应到下面这组示例数据,假定供应商的输入总数包含缓存命中量,而且没有缓存写入用量:
| 供应商返回的字段 | 数值 | 含义 |
|---|---|---|
prompt_tokens | 17903 | 全部输入 token,包含缓存命中的部分 |
cached_tokens | 17817 | 输入总数里命中缓存的部分 |
completion_tokens | 188 | 模型输出 token |
所以未命中缓存的输入是:
17903 - 17817 = 86插件最终上报的分类用量是:
input                   = 86     # 未命中缓存的输入
cache_read_input_tokens = 17817  # 命中缓存的输入
output                  = 188    # 模型输出
前两项相加仍然是 17903,而不是 35720。这就是原先“互斥桶”想表达的意思:每个 token 只归到一个类别里,不要让一个类别既包含总数,又和它的子项重复相加。
这里还要分清 rpi 和插件的职责。对当前源码里的 OpenAI Completions 适配器来说,rpi 先处理供应商字段:从 prompt_tokens 扣除缓存读取和缓存写入用量,得到内部 Usage.input;rpi-langfuse 再把这些已分类的用量转换成 Langfuse 字段。不是插件收到 prompt_tokens 后重新扣一次,否则又会少算。
不同供应商的字段含义可能不同,不能照着这个减法套所有响应。排查时先确认供应商的输入数是否包含缓存,再检查适配器和插件有没有重复拆分。费用还取决于模型价格配置或上报的成本数据,token 数正确不等于费用配置也一定正确。
对照源码看这两步
- rpi 主项目:bigfish1913/pi-rust。用量解析示例在
crates/rpi-ai/src/providers/openai_completions.rs的parse_usage,可以看到input = (prompt_tokens - cache_read - cache_write).max(0)。 - rpi-langfuse 插件:位于 pi-rust/rpi-package 的
packages/rpi-langfuse。实现入口为packages/rpi-langfuse/src/lib.rs:parse_usage读取 rpi 的内部用量,build_usage_details构造分类字段,build_cost_details构造成本字段。
以上函数关系对照了本次本地源码;链接指向 main,后续代码和行号可能变化,因此以函数名定位。
写入之后怎么确认:把同一条 Trace 查回来
写入成功不代表每个字段都放对了。可以先在界面检查这轮运行是否出现、模型和工具是否挂在同一个任务下,再用 observations API 核对具体字段。
这里的 v2 是读取 API 的版本号,不是 Langfuse 服务器的版本号。Langfuse v4 的这条查询路径仍然叫 /api/public/v2/observations。
下面的域名、密钥、trace ID 和时间区间都需要换成自己的值:
curl -G -u "pk-lf-xxx:sk-lf-xxx" \
  "https://langfuse.example.com/api/public/v2/observations" \
  --data-urlencode "traceId=4bf92f3577b34da6a3ce929d0e0e4736" \
  --data-urlencode "fields=core,basic,io,usage,model,trace_context" \
  --data-urlencode "fromStartTime=2026-10-05T00:00:00Z" \
  --data-urlencode "toStartTime=2026-10-06T00:00:00Z" \
  --data-urlencode "limit=100"
v2 返回的是 observation 行,不是一个完整的 trace 对象。要还原一条 trace,需要按 traceId 把这些行重新组织起来。
常用字段组如下:
core          id、traceId、startTime、endTime、parentObservationId、type
basic         name、level、userId、sessionId、isRootObservation
io            input、output
model         model、modelParameters
usage         usageDetails、costDetails
metrics       latency、timeToFirstToken
trace_context tags、release、traceName
没有请求的字段组通常不会出现在响应里,不是返回 null。所以想验证 tags、release 或 trace name,记得加上 trace_context。
rpi-langfuse 的最小验证方式
部署好扩展后,先跑一轮很小的任务,例如让 Agent 读取一个不含敏感信息的测试文件。用这条测试 trace 确认四件事:
- OTLP 端点返回成功。
- v2 observations API 能按
traceId查到 observation。 parentSpanId和起止时间符合预期。- model、input、output、usage 以及 session 等属性出现在正确的 observation 上。
排查顺序也按这个来:
HTTP 4xx / 401
  └── 查 URL、Basic Auth、header

HTTP 200 但查不到
  └── 查 x-langfuse-ingestion-version: 4
  └── 查 fromStartTime / toStartTime
  └── 查是不是读了旧 API

能查到但结构不对
  └── 查 traceId / spanId 格式
  └── 查 parentSpanId
  └── 查 observation.type
  └── 查 input/output 是否是字符串

数据重复或成本偏高
  └── 查是否同时发送了 legacy 和 OTLP
  └── 查 usage 桶是否重叠
接通之后,先用它回答一个具体问题
回到开头那个“回复改好了,文件却没变”的例子。接通观测链路后,先找到对应的一轮运行,再依次检查工具参数、工具返回值和后续模型输入。这些记录能帮我们缩小排查范围,而不是直接宣判模型或工具有问题。
Langfuse 负责接收和展示记录,Agent 端仍然需要负责把数据采集完整:
- 在 Agent 生命周期里正确划分根 span、generation 和 tool。
- 维护
trace_id、span_id、parent_span_id的关系。 - 在导出前补齐 trace 属性、输入输出、时间和 usage。
把这三层分开后,报文就没那么神秘了:
Agent 生命周期
    ↓
rpi-langfuse 内部 span
    ↓
OTLP ExportTraceServiceRequest
    ↓
Langfuse observation rows
    ↓
v2 observations / metrics
接入前还要留意数据边界:模型输入和工具输出可能包含源代码、个人信息或凭据。先确定哪些字段允许上报,做脱敏或截断,再扩大采集范围。可观测不等于把所有原始数据毫无保留地上传。
第一次接入不必追求大而全。先让一轮任务中的模型调用和工具调用出现在同一条 trace 下,能看清输入、输出、耗时和错误,就已经有了排查下一次问题的起点。
最后补一句:已有 v3 接入,迁移时要注意什么?
如果是第一次接入,按前面的 v4 路径验证即可,不必先研究旧接口。
如果已有 Langfuse v3 的接入代码,则要检查它使用哪条写入路径。OTLP 在 v3 时就已经受到支持,不能把区别简单理解成“v3 只能发事件,v4 才能发 span”。这里需要迁移的是 rpi-langfuse 原先使用的 legacy ingestion 路径:向 /api/public/ingestion 发送 trace-create、generation-create、generation-update 等事件。
原稿记录的接入错误就是发生在这条旧路径上:
400 Event type "trace-create" is not accepted by /api/public/ingestion
    when LANGFUSE_MIGRATION_V4_WRITE_MODE is events_only
这条响应说明,在该实例的 events_only 迁移配置下,这个端点不接受 trace-create。它不是“为什么所有人都该用 OTLP”的论据,也不是理解 Langfuse 的起点。对应的处理是检查旧接入代码,改用前面介绍的 OTLP 写入方式,并验证新路径的数据和字段,避免无意中双写。
版本边界:本文以 Langfuse v4 的 OTLP 写入配置为背景。服务端版本、SDK 版本和 URL 中的 API 版本号不是同一回事;旧接口的兼容行为还受实例迁移配置影响,部署时以当前文档和实际响应为准。rpi-langfuse 的事件名称及实现行为沿用原稿提供的项目素材,本次没有重新校验对应源码版本。
参考资料: